
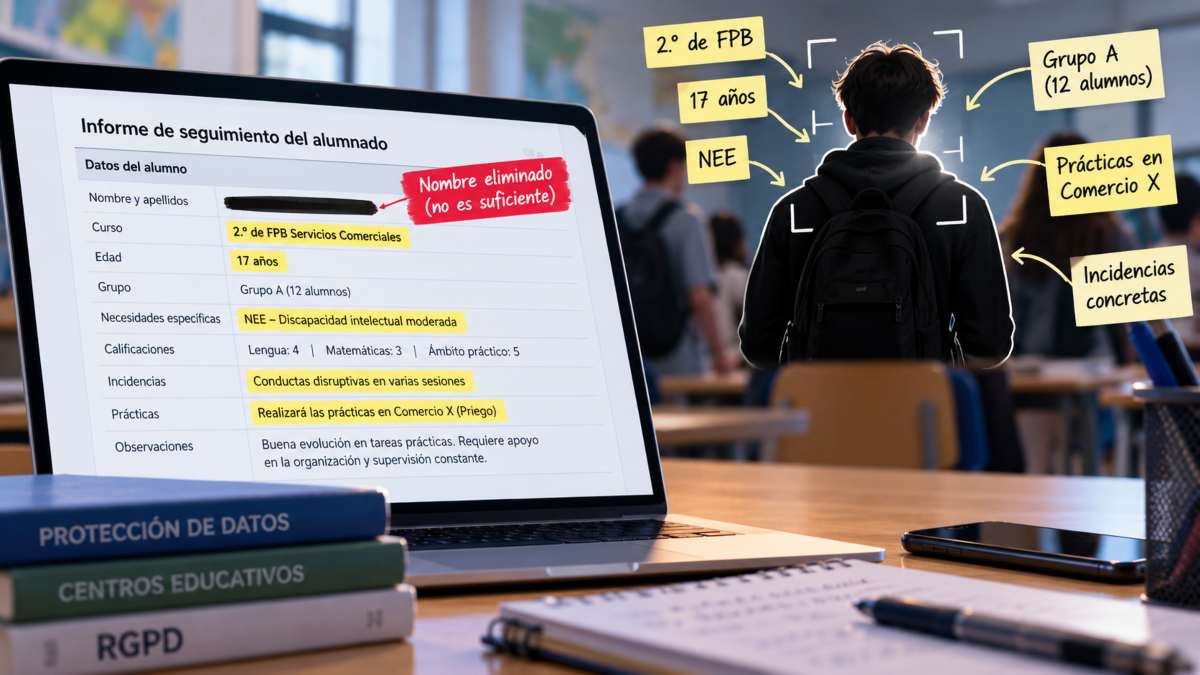
Un centro educativo puede creer que ha protegido la identidad de su alumnado porque ha eliminado nombres, apellidos o números de expediente de un documento. Sin embargo, esa operación no convierte automáticamente la información en anónima. A veces basta combinar curso, edad, una necesidad educativa concreta, una incidencia poco frecuente o una actividad determinada para reconocer a la persona de la que se habla.
La cuestión, por tanto, no es solo si hemos borrado los identificadores más evidentes. La pregunta útil es otra: ¿puede alguien identificar razonablemente al alumno utilizando la información que queda y otros datos a los que pueda tener acceso?
Borrar el nombre no siempre hace anónimos los datos
Los datos personales no se limitan al nombre y los apellidos. La Agencia Española de Protección de Datos recuerda que también son personales las informaciones que, reunidas, permiten identificar a una persona. Por eso una tabla sin nombres puede seguir conteniendo datos personales.
Pensemos en un grupo pequeño. Un documento menciona a “alumna de 17 años de segundo curso, con adaptación por una determinada necesidad y participante en una movilidad internacional”. Quizá no aparezca ningún identificador directo, pero para quienes conocen el centro puede existir una sola persona que encaje en esa descripción.
La anonimización exige mirar el conjunto, no únicamente cada columna por separado. El riesgo aparece precisamente en la combinación.
Anonimizar, seudonimizar y ocultar datos no es lo mismo
Sustituir “María López” por “Alumna 14” puede ser útil, pero no necesariamente anonimiza la información. Si el centro conserva una tabla que permite relacionar “Alumna 14” con María López, estamos ante una seudonimización.
La diferencia es importante. La AEPD señala que los datos seudonimizados siguen siendo datos personales cuando pueden atribuirse de nuevo a una persona mediante información adicional. La anonimización, en cambio, pretende que la persona deje de ser identificable de forma razonable.
Tampoco basta con ocultar visualmente una columna en una hoja de cálculo, cambiar el nombre de un archivo o eliminar el encabezado de un informe. La protección debe afectar a la información que realmente se comparte y a la posibilidad de reconstruir la identidad.
Cómo puede identificarse a un alumno sin que aparezca su nombre
Los identificadores indirectos son especialmente relevantes en educación porque los centros trabajan con comunidades relativamente pequeñas.
Datos indirectos y combinación de variables
Curso, grupo, edad, localidad, optativas, fecha de una incidencia, participación en un programa, absentismo, calificaciones o determinadas circunstancias familiares pueden parecer poco reveladores por separado. Juntos pueden formar una descripción casi única.
Cuanto más detallado sea el conjunto compartido, mayor debe ser la revisión de esas combinaciones.
Grupos pequeños y casos únicos
Un dato agregado puede ser suficientemente general en un centro grande y resultar identificativo en un grupo de seis alumnos. Decir que “el 100 % del alumnado con determinada necesidad superó el módulo” puede equivaler a hablar de una persona concreta si solo existe un alumno con esa característica.
La anonimización no puede separarse del contexto.
Informes, observaciones y texto libre
Los campos abiertos son todavía más delicados. Un comentario puede contener nombres de familiares, diagnósticos, lugares, fechas, conflictos o detalles biográficos que permitan reconocer a la persona aunque los campos estructurados hayan sido limpiados.
Por eso no basta con automatizar la eliminación de columnas. Los textos libres necesitan una revisión específica.
Antes de compartir datos: qué necesitamos realmente y para qué
Una buena protección empieza antes de anonimizar. Empieza preguntando por qué necesitamos compartir esa información.
El principio de minimización del RGPD exige que los datos sean adecuados, pertinentes y limitados a lo necesario para la finalidad perseguida. Si para analizar resultados académicos basta conocer módulo, curso y resultado agregado, quizá no exista ninguna razón para incluir edad exacta, grupo, observaciones individuales o circunstancias personales.
Esta pregunta simplifica el problema: los datos que no se comparten tampoco necesitan ser protegidos frente a ese intercambio.
Conviene formular tres cuestiones: qué decisión queremos tomar con los datos, qué variables son imprescindibles para hacerlo y cuáles estamos incluyendo simplemente porque ya estaban disponibles.
Con quién compartimos la información también cambia el riesgo
La misma información puede tener riesgos diferentes según quién la reciba y qué otros datos posea.
Personal del centro
Que la información circule dentro del centro no significa que deba ser accesible para cualquiera. El acceso debe responder a una necesidad vinculada a las funciones profesionales.
Proveedores y plataformas
Cuando los datos salen de los sistemas del centro entran en juego nuevas preguntas: qué servicio los recibe, con qué finalidad, dónde se almacenan, cuánto tiempo permanecen allí y qué condiciones regulan su tratamiento.
Herramientas de IA
Copiar un informe en una herramienta de IA es también una forma de tratamiento y comunicación de información. Eliminar el nombre antes de pegarlo no resuelve automáticamente el problema si el texto mantiene suficientes detalles para identificar al alumno.
La pregunta no debe ser “¿he quitado el nombre?”, sino “¿necesito introducir datos personales para obtener esta ayuda?”. Muchas tareas pueden resolverse con un caso ficticio, una estructura vacía o información verdaderamente agregada.
Imágenes, audios y trabajos: cuando el propio contenido identifica
No toda identificación se produce mediante texto. Una fotografía puede mostrar un rostro, un uniforme, una matrícula o un espacio reconocible. Una grabación puede identificar por la voz. Un trabajo puede incluir el nombre del alumno en sus propiedades, referencias a experiencias personales o información incrustada en el archivo.
Antes de compartir materiales para formación, investigación, difusión o análisis conviene revisar tanto el contenido visible como la información asociada al archivo.
La AEPD recuerda específicamente a los centros educativos que la publicación de contenidos que permitan identificar al alumnado exige atender a la base jurídica correspondiente y recomienda disociar o anonimizar cuando proceda.
Un método práctico para comprobar si los datos están realmente anonimizados
Un centro no necesita convertir cada intercambio de información en una auditoría compleja, pero sí puede adoptar una secuencia sencilla.
Primero, definir la finalidad. Segundo, eliminar todo lo que no sea necesario. Tercero, retirar identificadores directos. Cuarto, buscar combinaciones de datos que puedan singularizar a alguien. Quinto, revisar textos libres y archivos adjuntos. Sexto, considerar qué información adicional posee el destinatario. Séptimo, preguntarse si la identidad podría reconstruirse con un esfuerzo razonable.
Si la respuesta genera dudas, lo prudente no es etiquetar el archivo como “anónimo”, sino tratarlo como información personal y aplicar las garantías correspondientes.
La prueba final: ¿alguien podría volver a identificar al alumno?
La anonimización no consiste en hacer que la identidad sea menos visible. Consiste en impedir que pueda reconstruirse razonablemente.
Por eso borrar nombres puede ser un primer paso, pero nunca una prueba suficiente. Un centro que quiera compartir información con seguridad debe mirar los datos como los miraría quien los recibe: qué sabe ya, qué podría cruzar y qué detalles hacen único a cada caso.
La mejor comprobación final es sencilla de formular: si entregamos este conjunto de datos a la persona o sistema que va a recibirlo, ¿podría llegar razonablemente a saber de quién estamos hablando?
Si la respuesta es sí, o no podemos responder con seguridad, todavía no tenemos datos anónimos.
Cómo cambia el análisis cuando pensamos en escenarios reales
La dificultad de anonimizar se entiende mejor con casos concretos. Imaginemos que un departamento quiere compartir con otro centro los resultados de una experiencia metodológica. El archivo no contiene nombres, pero sí curso, sexo, edad, calificación inicial, calificación final y una columna de observaciones. En un grupo de treinta alumnos, algunas combinaciones pueden ser frecuentes. Otras no: quizá solo exista una alumna de determinada edad que se incorporó tarde y cuya observación menciona una circunstancia muy conocida. El riesgo no está en una variable aislada, sino en la posibilidad de singularizar.
Otro ejemplo: se quiere mostrar en una formación un caso de mejora de absentismo. Se elimina el nombre, pero se conserva el porcentaje exacto de faltas, el ciclo, el trimestre y una descripción del motivo. Para alguien ajeno al centro puede parecer anónimo. Para compañeros, profesorado o familias puede ser perfectamente reconocible. La audiencia modifica el riesgo.
Esto explica por qué no existe una lista universal de columnas que baste con borrar. La anonimización exige valorar medios razonables de identificación, contexto y destinatarios. Un conjunto puede ofrecer más protección en un entorno y menos en otro.
También debemos evitar el error contrario: pensar que cualquier información educativa es imposible de compartir. Se pueden publicar estadísticas, analizar resultados y aprender de experiencias siempre que se diseñe el conjunto con la finalidad y la minimización en mente. El objetivo no es bloquear el uso de datos, sino evitar que utilicemos información identificable cuando no la necesitamos.
Generalizar, agrupar y reducir precisión
Eliminar variables no es la única técnica. En ocasiones podemos reducir precisión. En vez de edad exacta, utilizar un intervalo; en vez de fecha concreta, trimestre; en vez de localidad, una categoría territorial suficientemente amplia; en vez de una calificación con decimales, rangos. Agrupar disminuye la posibilidad de singularización, aunque también reduce detalle analítico.
Aquí aparece una decisión importante: cuánta precisión necesitamos para responder a la pregunta. Si la investigación pretende saber si una intervención mejora resultados en términos generales, quizá no necesitemos conservar cada dato individual. Si necesita estudiar diferencias por variables concretas, tendremos que valorar con más cuidado el tratamiento.
La buena anonimización no consiste en destruir información al azar. Consiste en conservar la utilidad necesaria reduciendo el riesgo de identificación. Por eso conviene definir primero la pregunta. Sin finalidad clara, tendemos a conservar “por si acaso”, justo lo contrario de la minimización.
El problema de los conjuntos pequeños
Los centros educativos generan continuamente subconjuntos pequeños: alumnado con una materia pendiente, participantes en una movilidad, estudiantes con una medida específica, personas que han sufrido una determinada incidencia. Publicar porcentajes sobre estos grupos puede revelar más de lo que parece.
Si en un grupo hay una sola persona y afirmamos que el 100 % de quienes presentan una característica obtuvieron determinado resultado, el dato agregado no protege nada. Incluso con dos o tres personas pueden inferirse resultados cuando se combinan varias tablas.
Esto obliga a revisar no solo cada documento, sino la posibilidad de cruzarlo con otros datos públicos o conocidos. Horarios, fotografías de actividades, noticias del centro, listados de participantes o información difundida en redes pueden facilitar la reidentificación.
No se trata de imaginar ataques extraordinarios. La prueba debe considerar lo razonablemente accesible para quien recibirá la información.
Qué hacer con las herramientas de inteligencia artificial
La popularización de asistentes de IA introduce una situación nueva porque copiar y pegar se ha convertido en una acción cotidiana. Un docente puede querer resumir un informe, mejorar su redacción, crear una adaptación o analizar respuestas. La facilidad de uso puede hacer olvidar que el contenido sigue siendo información.
Antes de introducir un texto real conviene separar la tarea del dato. Si queremos mejorar la estructura de un informe, podemos pedir una plantilla sin incluir ningún caso. Si queremos simplificar un texto, podemos sustituir detalles por variables ficticias. Si necesitamos analizar patrones, quizá podamos trabajar con datos agregados.
Cuando el uso de datos personales sea realmente necesario, la decisión ya no debe tratarse como una improvisación individual: habrá que utilizar las herramientas, configuraciones y garantías autorizadas por la organización y comprobar las condiciones aplicables.
La IA tampoco convierte automáticamente en anónima una información porque el usuario haya omitido el nombre. Un relato biográfico detallado puede identificar mejor que una tabla.
Un ejercicio útil para equipos docentes
Puede hacerse una prueba sencilla en formación interna. Se entrega un caso supuestamente anonimizado y se pide a varios profesionales que señalen qué variables podrían permitir reconocer a la persona. Después se repite el ejercicio imaginando distintos destinatarios: alguien de otro país, una familia del centro, un compañero del mismo grupo y una plataforma externa.
El resultado suele mostrar que “anónimo” no es una propiedad visual del documento. Depende de lo que contiene y del contexto en el que circula.
El ejercicio también ayuda a cambiar hábitos. En vez de preguntar únicamente “¿he borrado el nombre?”, el equipo empieza a preguntar “¿por qué necesito este dato?”, “¿puedo agruparlo?”, “¿qué sabe ya quien lo recibe?” y “¿qué podría inferir?”.
Errores frecuentes que conviene detectar
Un error es confundir iniciales con anonimización. Otro es utilizar un código estable y pensar que, por no ser legible, deja de ser dato personal. También es frecuente mantener fechas exactas innecesarias, copiar observaciones completas, compartir capturas de pantalla con información periférica o olvidar metadatos y nombres de archivo.
Otro fallo aparece al anonimizar una tabla y adjuntar después el documento original “para que se entienda mejor”. La protección debe abarcar el paquete completo.
También conviene desconfiar de expresiones como “esto solo lo verá el equipo”. El acceso limitado puede ser una medida de seguridad, pero no convierte los datos en anónimos. Si las personas autorizadas pueden identificar al alumno, seguimos trabajando con datos personales.
Una política de centro puede ser breve
No hace falta redactar un manual de cincuenta páginas para mejorar la práctica. Un centro puede establecer un circuito sencillo: definir finalidad, comprobar si pueden usarse datos anónimos o agregados, minimizar, revisar identificadores directos e indirectos, comprobar destinatario y canal, y consultar al responsable correspondiente cuando exista duda.
Ese procedimiento debería incluir ejemplos educativos reales. Las normas abstractas se olvidan; los casos permiten reconocer el problema cuando aparece.
También resulta útil diferenciar usos habituales: coordinación interna necesaria, difusión pública, investigación, formación, proveedores externos y herramientas de IA. No todos presentan el mismo riesgo ni requieren la misma respuesta.
La prueba del compañero informado
Una comprobación práctica consiste en imaginar a una persona que conoce el centro pero no tiene acceso al listado original. ¿Podría reconocer a alguien con lo que hemos dejado? Esta prueba no sustituye un análisis formal cuando sea necesario, pero obliga a mirar el documento desde fuera.
Después podemos elevar la exigencia: ¿qué ocurriría si esa persona pudiera consultar la web del centro, redes sociales o noticias públicas? ¿Y si conoce el grupo? ¿Y si combina dos tablas que publicamos por separado?
La anonimización robusta debe sobrevivir razonablemente a esas preguntas.
Compartir menos puede producir mejores análisis
Existe además un beneficio metodológico. Acumular variables irrelevantes puede distraer del objetivo. Cuando obligamos a justificar cada dato, el análisis suele ganar claridad. Sabemos qué pregunta responde cada variable y evitamos interpretaciones oportunistas.
La minimización no es solo una obligación de protección. Puede funcionar como disciplina intelectual: recoger lo que necesitamos, saber para qué y evitar la tentación de convertir cualquier información disponible en una variable analítica.
Una decisión que debe poder explicarse
Si un centro comparte un conjunto de datos, debería poder explicar por qué considera adecuada la protección aplicada. No basta con una sensación de seguridad. Debe existir una lógica: finalidad, variables necesarias, transformaciones realizadas, destinatario, posibilidad de cruce y medidas complementarias.
Esta trazabilidad es especialmente importante cuando se reutilizan conjuntos. Un archivo preparado para un equipo interno no debería publicarse después en una web sin una nueva revisión. Cambiar el destinatario cambia el contexto.
Cierre práctico
Antes de enviar un archivo, presentar un caso, utilizar datos en una formación o introducir información en una herramienta externa, conviene detenerse unos minutos. ¿Necesitamos casos individuales? ¿Podemos agregar? ¿Hemos reducido precisión? ¿Quedan casos únicos? ¿El texto libre revela detalles? ¿Qué sabe el destinatario? ¿Podría cruzarlo con otra información?
La pregunta final sigue siendo la más exigente: ¿existe una probabilidad razonable de que la persona vuelva a ser identificada? Si la respuesta es afirmativa o no podemos justificar con suficiente seguridad que sea negativa, no deberíamos llamar anónimo al conjunto.
La protección de datos mejora cuando deja de verse como una tarea de borrar nombres al final y pasa a formar parte del diseño desde el principio. Ahí está el cambio importante: no “limpiar” después todo lo que hemos recogido, sino pensar antes qué información necesitamos realmente.
Qué debería quedar documentado antes de compartir
En intercambios recurrentes conviene dejar una pequeña ficha de decisión. Debe indicar la finalidad, el destinatario, las variables incluidas, las transformaciones aplicadas y la razón por la que el conjunto conserva utilidad sin mantener identificadores innecesarios. No se trata de crear burocracia adicional, sino de evitar que dentro de seis meses nadie recuerde por qué se consideró adecuado un archivo.
La documentación también facilita revisar cambios. Si añadimos una variable nueva, ampliamos destinatarios o publicamos información que antes circulaba internamente, podemos detectar que el análisis original ya no sirve.
Cuando la anonimización reduce demasiado la utilidad
Existe un equilibrio real. Si agrupamos tanto que los datos dejan de responder a la pregunta, la solución no es fingir que siguen siendo útiles. Quizá necesitemos trabajar con datos personales bajo garantías adecuadas en vez de intentar convertirlos a toda costa en anónimos.
Esta distinción es importante: anonimizar no es siempre obligatorio ni siempre posible manteniendo la finalidad. Lo incorrecto es llamar anónimo a lo que sigue siendo identificable para evitar reconocer que estamos tratando datos personales.
Formación práctica, no solo normativa
El profesorado no necesita memorizar artículos del RGPD para detectar muchos riesgos cotidianos. Necesita reconocer escenas: una captura de pantalla, un informe pegado en una IA, una tabla para una ponencia, un trabajo compartido como ejemplo o una fotografía de actividad.
Una formación útil puede partir de esos objetos y preguntar qué información contienen, qué puede inferirse y cómo conseguir la misma finalidad con menos datos. Después la normativa da marco a decisiones que ya se entienden.
Una cultura de minimización
El cambio más profundo aparece cuando el centro deja de recoger información “por si acaso”. Cada campo debería tener una razón. Cada copia debería tener un destinatario. Cada conservación debería responder a una necesidad.
Esa cultura reduce riesgo, pero también simplifica sistemas. Menos datos irrelevantes significan menos errores, menos duplicidades y análisis más claros.
La protección deja entonces de ser una barrera colocada al final y se convierte en criterio de diseño. Antes de crear un formulario preguntamos qué necesitamos; antes de exportar preguntamos quién lo recibirá; antes de utilizar una herramienta preguntamos si podemos resolver la tarea sin datos personales.
Diez comprobaciones antes de pulsar enviar
Como síntesis operativa, un centro puede utilizar diez preguntas: ¿cuál es la finalidad?, ¿necesitamos datos individuales?, ¿podemos agregarlos?, ¿hemos eliminado identificadores directos?, ¿quedan combinaciones únicas?, ¿hay texto libre?, ¿existen imágenes o metadatos?, ¿qué información adicional tiene el destinatario?, ¿podría cruzar otras fuentes?, ¿podemos defender razonadamente que la persona ya no es identificable?
La lista no sustituye asesoramiento cuando el caso lo requiere. Sirve para evitar errores básicos y, sobre todo, para cambiar la pregunta inicial.
Anonimizar no es borrar una columna. Es diseñar un conjunto de información en el que la identidad deje de ser razonablemente recuperable. Esa diferencia conceptual debería ser el punto de partida de cualquier centro que quiera compartir datos con rigor.